r&d notes · no.06
先有故事,才有畫面
從小馬、武俠到 MONDO 拾便袋,談帶學生做行銷影音的意義
撰文:丁后儀|2026.09.23|閱讀約 6 分鐘|瀏覽 – 次
短影音早已成為品牌與人溝通的日常語言;而生成式 AI 的日新月異,更讓「做出一段畫面」從專業團隊的工作,變成人人都能嘗試的事。
我是拿畫筆出身的老師:大學讀雕塑,在英國攻讀博士時專研創造力教學,回到大學後教色彩學、簡報美學與專業演講力,也教行銷。美感、表達與實作,始終是我教學的三條主線。今年 3 月起,我開始用 AI 做影片:從課堂示範的小馬故事、以分鏡說故事的武俠片段,到 9 月為自家品牌 MONDO 改編的拾便袋行銷短片。做著做著,我愈來愈確定一件事:先有故事,才有畫面。
這篇文章想以這三部作品為例,藉由回顧我從隨興嘗試到角色定錨的歷程,探討帶學生做行銷影音的必要性,以及美感、表達與實作在其中的學習意義。
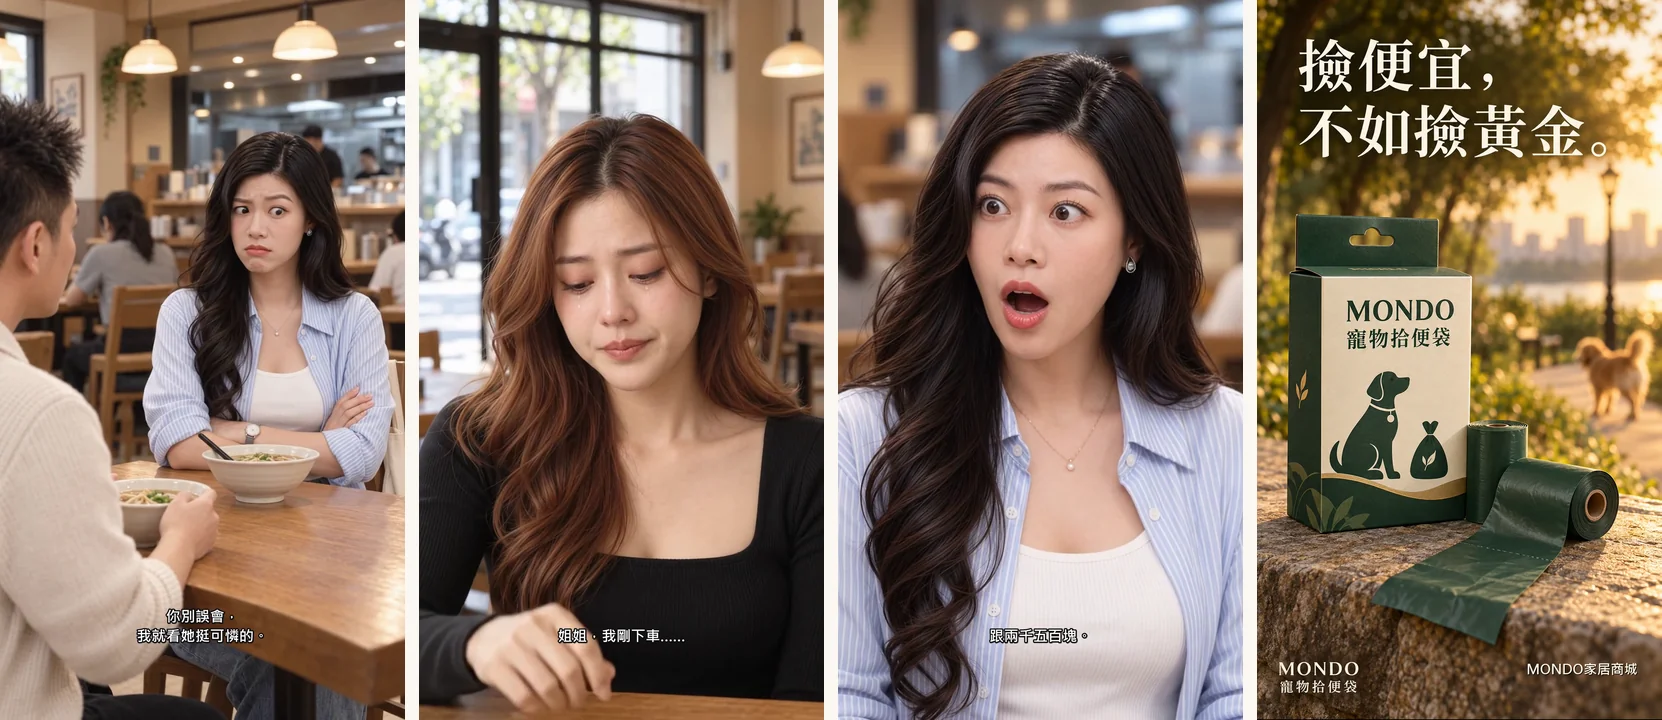
先有故事,才有畫面;先有角色,才有分鏡。
三部作品,一條自己走過的學習曲線
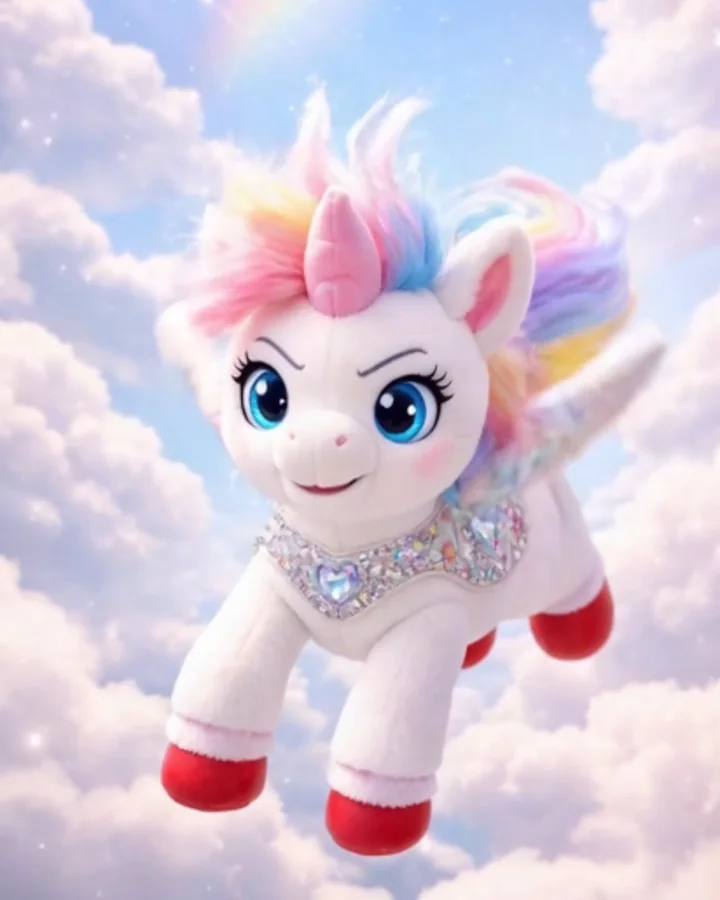
小馬故事:絨毛小馬救小貓
一隻穿上披風的絨毛小馬,從大蛇口中救出小貓。我把一段段數秒鐘的 AI 短片段,剪成約兩分鐘的故事,也第一次發現:換一個鏡頭,主角就可能換一張臉。
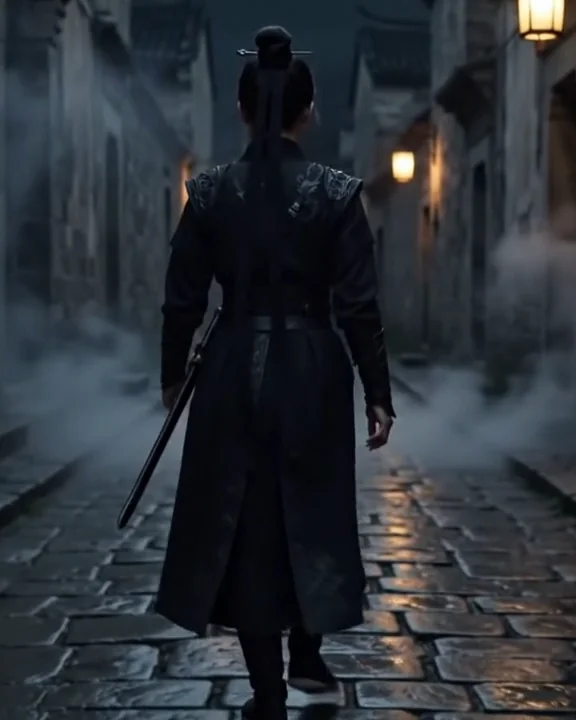
武俠:雨夜巷弄裡的女俠
我先做出 20 格、每格一秒的分鏡,從「她緩步前行」寫到最後一句字幕「因為回頭的人,都死了。」節奏與情緒,都先在分鏡上想清楚。
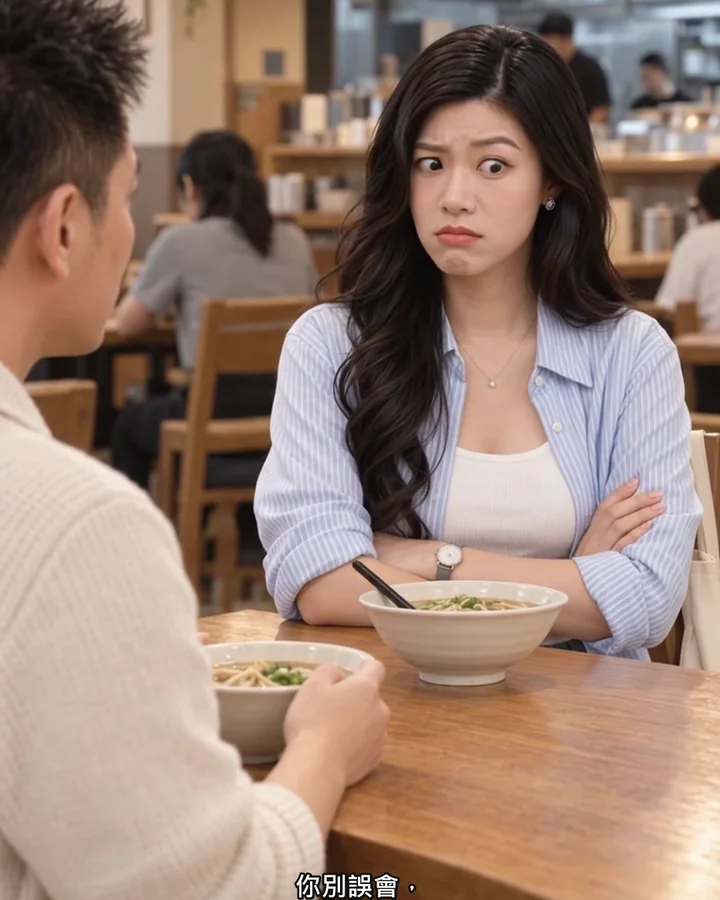
MONDO:撿便宜不如撿黃金
為自家品牌 MONDO 做的寵物拾便袋行銷片。借網路短影音的梗,三個角色、十二個鏡頭、38 秒;角色多視圖與逐鏡影格都先定好,再交給工具生成。
從隨興嘗試到角色定錨,從自己玩到能教人――實作,是最好的老師。
先有故事:好故事,勝過好畫面
畫面再美,沒有轉折與核心訊息,就留不住人。MONDO 這支片只有 38 秒,卻要走完一個完整的起承轉合:
- 起善意「慢慢吃,別餓著。」男主角請一位陌生女孩吃麵,同伴在一旁問:「他誰啊?」
- 承求助與懷疑女孩說手機和錢都不見了,男主角掏錢讓她先住一晚;同伴卻質疑:「她要是騙子呢?」
- 轉反轉「應該不可能,因為我剛真撿到手機……跟兩千五百塊。」
- 合品牌「撿便宜,不如撿黃金。」MONDO 寵物拾便袋登場。
畫面讓人停下來,故事讓人記住你。
這樣的轉折,靠的不是工具,而是說故事的能力。我在專業演講力與簡報課上常提醒學生:開頭要立刻抓住人,內容要貼近生活、引起共感,結尾要用一句金句讓人記得住。行銷影片亦然;學生每天滑過無數短影音,記得的往往是一個梗、一句台詞,而不是畫面有多精緻。
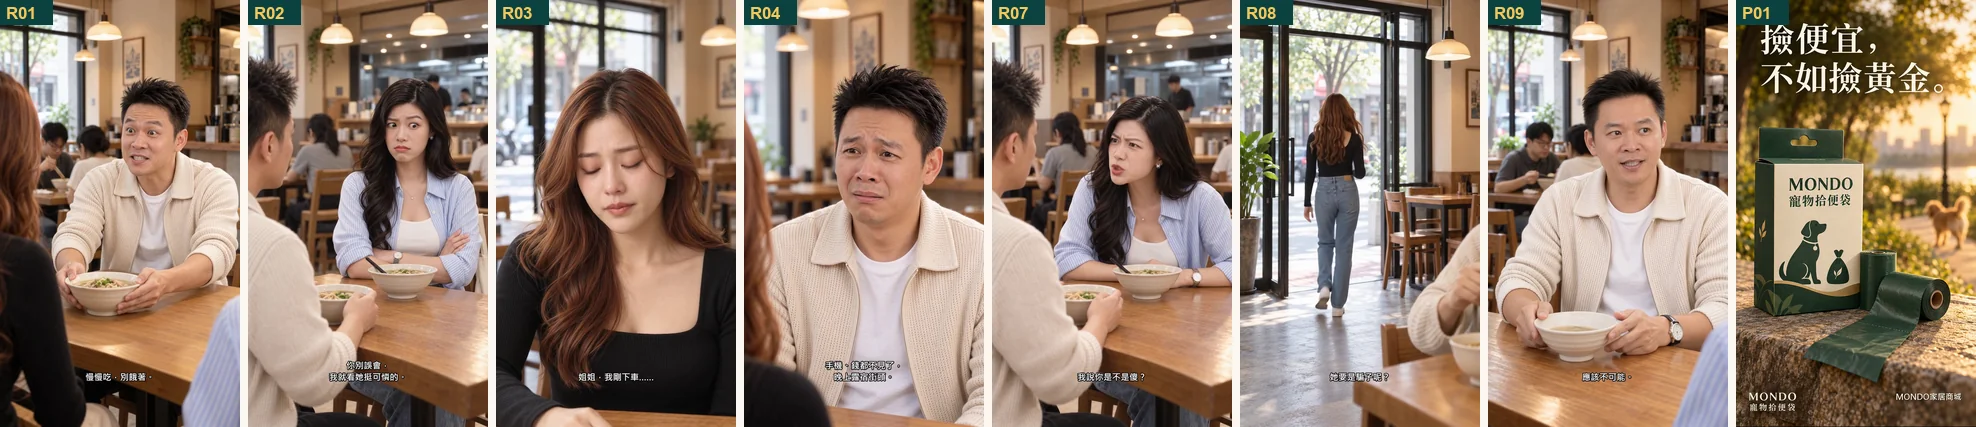
好故事勝過好畫面;台詞與轉折,要在生成之前就寫好。
再有角色:換一鏡,不能換一張臉
AI 生成影片最常見的困擾,是同一個角色在不同鏡頭裡長得不一樣。做小馬故事時,我便開始為小貓與大蛇畫三視圖;到了 MONDO,三個角色更有正面、側面、背面的全身圖與五官特寫,有時再加上表情圖,替角色「定錨」。
這背後,其實是美感的判斷:角色的造型、服裝的色彩、場景的光線,都要前後一致,觀眾才會相信這是同一個世界。我在色彩學與藝術設計課上教的,正是這種看見細節、維持一致的眼光;AI 能生成畫面,卻不會替我們看出哪裡走樣了。
理論依據電影剪輯講究連戲(Continuity Editing):鏡頭之間的人物、服裝、動作與光線前後一致,觀眾才能專注在故事上。角色定錨,就是在生成之前先守住連戲。
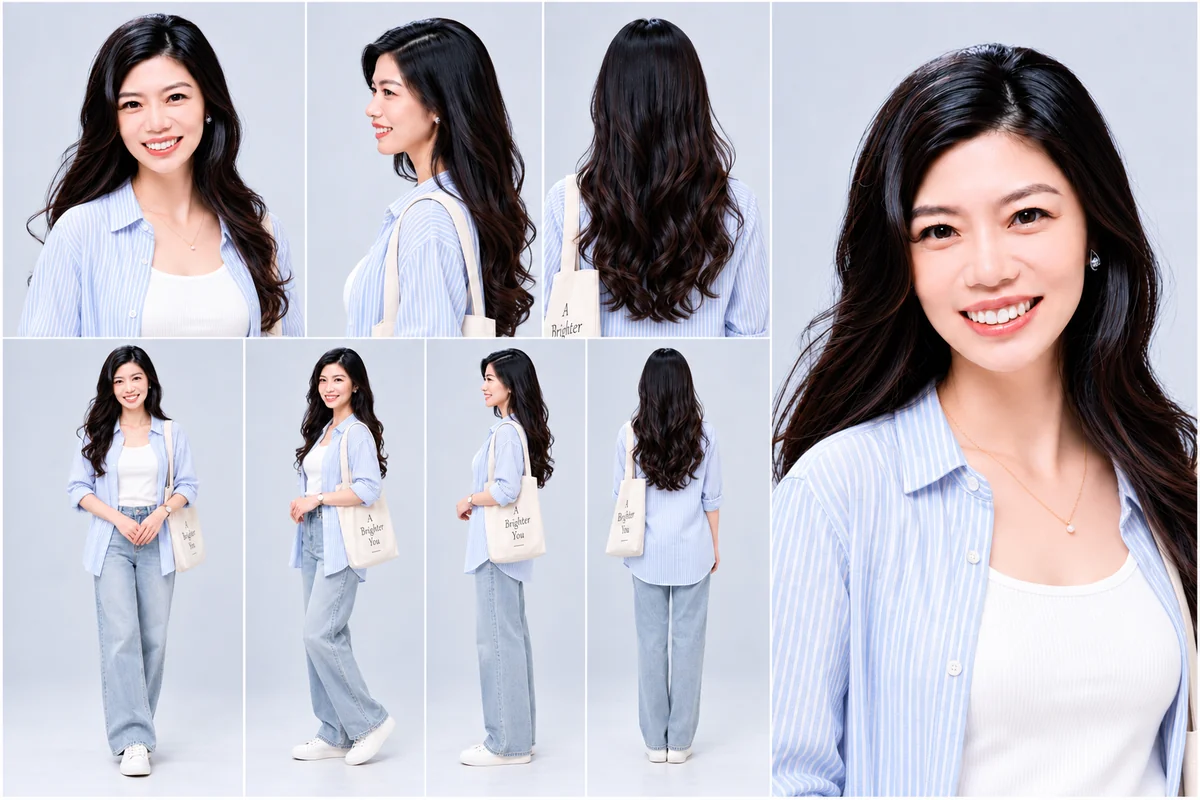
角色先定錨,故事才走得遠。
最後才是工具:一鏡,只有幾秒
AI 影片工具每次只能生成幾秒鐘:小馬故事以 Grok 生成,片段一段約 6 秒;MONDO 每一鏡從生成到採用,也多半只有數秒。因此,一支 30 到 40 秒的影片,必須先想好總長,再拆成一個個鏡頭;武俠片段的 20 格分鏡,每格一秒,便是先把節奏想清楚。
這一路,我試過不少工具:Grok、Google Flow、Seedance,也試過 Claude;最後的後製、合成與剪輯,則交給 Codex。工具各有所長,也不斷推陳出新;不變的是分工要清楚。以 MONDO 為例,故事、角色與分鏡圖先在 ChatGPT 完成並確認,Google Flow 只負責把確認過的畫面變成影片。後來設計企業工作坊時,我也把順序定為:
故事、台詞與總長
三視圖與表情圖
依工具秒數拆成每一鏡
先試一鏡,再生其餘
如果第一步還不拆鏡,就專心把故事、角色、台詞與總長做好;鏡頭與工具設定,留到下一步。(工作坊網站的設計,請見研發手記〈讓學員不迷路的教學網站〉。)
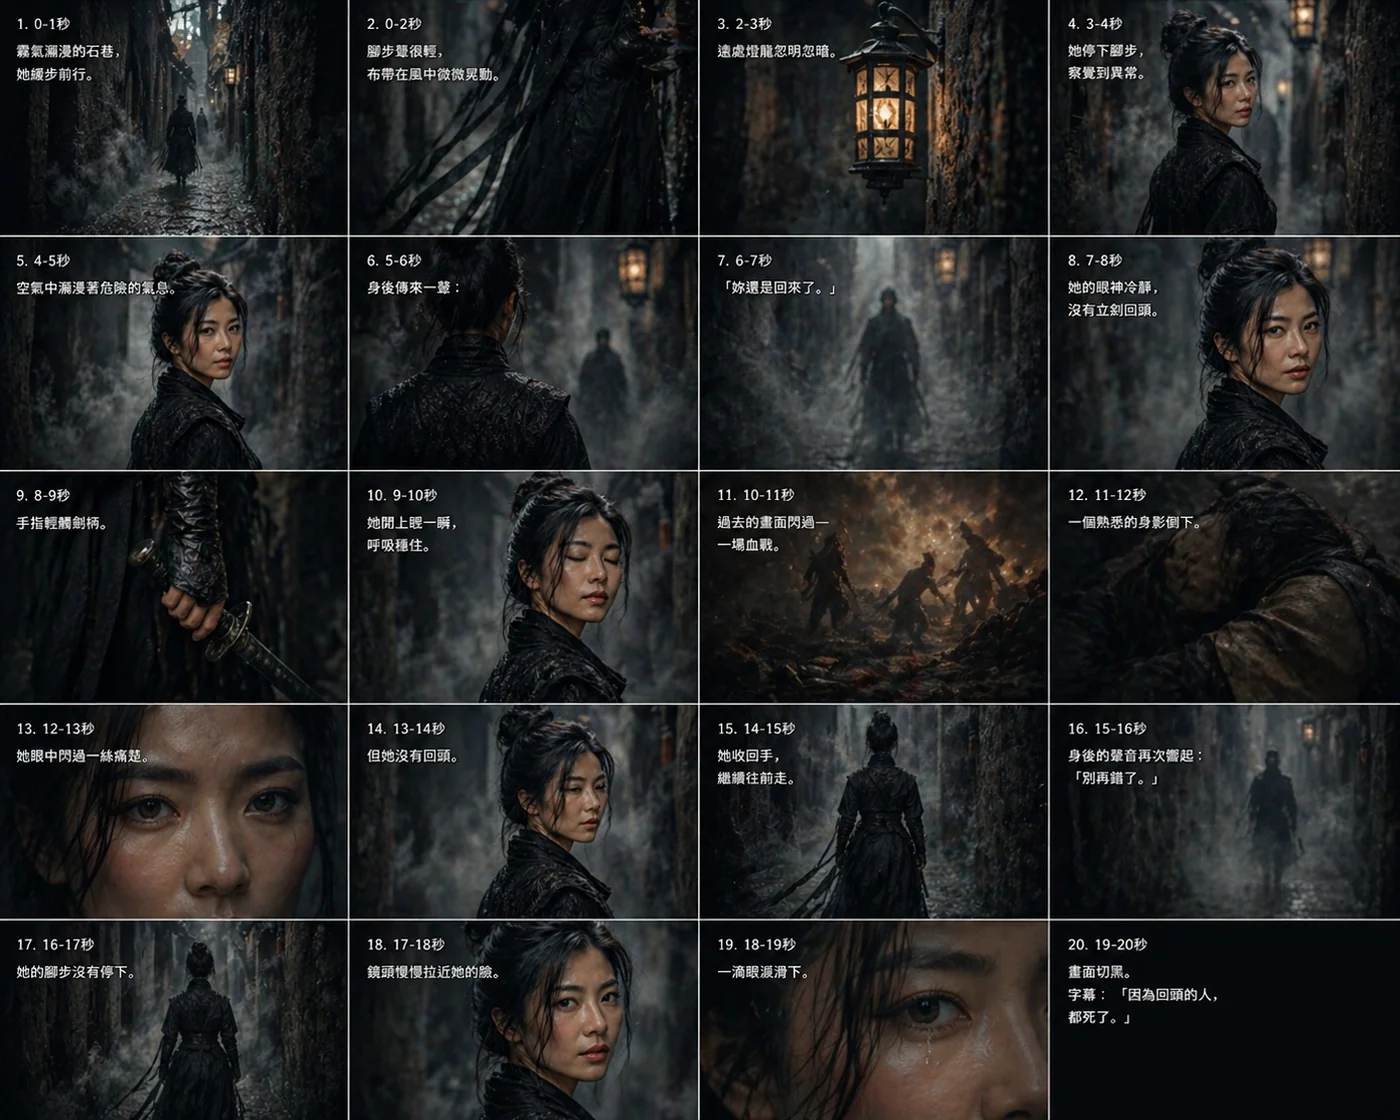
先想好總長再拆鏡,工具才派得上用場。
為什麼要帶學生做行銷影音
親手做過這幾部影片,我更加確信:帶學生做行銷影音,有其必要。它不只是一項媒體技能,而是一段完整的學習歷程――學生得先理解受眾,再構思故事、設計角色、規劃鏡頭,最後為作品負責。
這也呼應我在博士研究時投入的「可能性思考」(Possibility Thinking):從「如果……會怎樣?」(what if)到「就當作……」(as if),讓學習者在想像與實作之間,創造新的可能。
而「做」本身,就是學習。MAPS 教學設計模型中的 P(Practice,實作內化),強調的正是透過實作,把理解轉成能力;學生唯有親身經歷角色走樣、秒數超出的挫折,才真正懂得規劃的價值。
理論依據經驗學習(Experiential Learning):在具體經驗、反思、概念化與再實踐的循環中,學習才得以深化;做中學,正是行銷影音實作的核心。
帶學生做行銷影音,至少有三個理由:
一支影片,整合了受眾、故事、視覺、聲音與團隊協作。
人人都能生成畫面,差別在於判斷與取捨。
從每天滑短影音的觀看者,變成能說故事的創作者。
所以比起操作工具,我更想涵養學生說故事所需的美感、表達與判斷。
做影片的過程,就是最好的學習
01同理受眾,定義問題
先問誰會看、他們在意什麼,再決定要說什麼。這正是設計思考的起點:從人出發,而不是從工具出發。
02故事結構與轉折
用 30 秒說一個有轉折、有核心訊息的故事,是表達力最扎實的練習;台詞要短,轉折要準,結尾要讓人記得住。
03角色與分鏡的規劃力
角色定錨、總長與拆鏡,都要先想好再動手。規劃,是把想像落地的能力;也是學生在任何專案裡都用得上的能力。
04智財、肖像與 AI 標示
用了誰的臉、誰的聲音、誰的梗,生成的內容如何標示,都要說得清楚。對作品負責,是數位時代創作者的基本素養。
相關案例課程故事〈從下指令到做判斷〉:AI 文案與數位行銷課,如何讓學生對發布的內容負責 ↗一位大學教師的省思:生成容易,判斷更難
越是人人都能生成,越需要會說故事、有美感、肯動手的人。
AI 讓畫面唾手可得,學生還需要學美感嗎?還需要練表達嗎?還需要親手做嗎?我的答案是肯定的――正因為生成變得容易,判斷什麼值得留下、什麼該捨去,才更顯珍貴。我在教學實踐研究中關注學生的美感表達能力,也是出於同樣的信念。誠然,AI 影片仍有角色走樣、嘴型與口音不夠自然等限制,老師與學生都得一鏡一鏡把關;而這份把關的過程,恰恰是最好的學習。
未來,帶進教學與研發
帶進大學行銷課
讓學生以真實或擬真的品牌為對象,完整走過受眾分析、故事、角色、分鏡到成片,並把企劃與修改的歷程,視為學習的證據。
教學生先說好故事
課程的重心放在故事、角色與台詞,工具操作放在後面:先寫出 30 秒的好故事,再談生成,進而涵養學生的表達力與判斷力。
文中畫面取自作品成片與製作素材;MONDO 為作者自有品牌。
本文提及與延伸閱讀
- 工具Grok(xAI)
- 工具Google Flow
- 工具Seedance(ByteDance Seed)
- 工具Codex(OpenAI)
- 工具Claude(Anthropic)
- 概念起承轉合(維基百科)
- 概念連戲剪輯 Continuity Editing(維基百科)
- 概念分鏡(維基百科)
- 概念設計思考:Stanford d.school
- 理論Craft et al.:Possibility thinking 研究(University of Exeter)
- 理論經驗學習(維基百科)
- 模型MAPS 單元教學設計模型(教學心法)
- 案例課程故事〈從下指令到做判斷〉
- 手記研發手記〈讓學員不迷路的教學網站〉
交流園地
歡迎留下想法與我交流。填暱稱即可留言,留言會公開顯示,請勿留下個資。