r&d notes · no.05
把教學專業,寫成 AI 的紅線
老師裁決、AI 施工:VoiceUp 演講陪練系統的開發歷程
撰文:丁后儀|2026.09.22|閱讀約 6 分鐘|瀏覽 – 次
分享線上 KTV 時,我寫下「一個晚上,一間 KTV」;然而,要陪三十位學生練一整個學期的系統,卻不可能只靠一個晚上。從今年七月的第一次需求對談,到十月初完成闖關、戰力榜、攻略本與長老小屋,VoiceUp 前後留下了 88 次版本紀錄。
差別不在程式,而在責任。私人的小工具,好不好用由自己承擔;陪學生學習的系統,牽動的是學生的練習、回饋與研究資料,每一個數字、每一句回饋,都必須經得起檢驗。
VoiceUp 是遊戲化設計,也是 AI 應用、UI/UX 與大腦科學的結合。這篇文章想以它的開發歷程為例,聚焦其中的 AI 應用,藉由回顧我與 AI 的分工、寫給 AI 的紅線,以及幾次自己當學生測出來的轉折,探討教師如何在人機協作中守住教學專業。(遊戲化的設計初衷,請見研發手記 No.04。)
AI 會寫程式,但「什麼是好的表現」,只有老師知道。
分工:先有工作流,才有程式
動工之前,我先為這個專案設計了一套 CCS 工作流:說清楚目標與人、AI 各自的角色,再拆成節點,設下守門的檢查點,以及必須由我親自裁決的關卡。
角色、節點、守門點與關卡。
先描述兩個理想的使用情境。
規格書、紅線與交接清單。
每一個衝刺,由我逐項驗收。
工作流在 Claude Cowork 中整理成交接包,Claude Code 讀完才開工;村莊、角色與攻略本的圖表,則由我以 ChatGPT 生成。
程式碼全由 AI 撰寫;我的角色,是說清楚情境、做出裁決,以及退件。
AI 施工
- 撰寫程式與資料庫
- 自我測試、找出漏洞
- 整理規格、題庫與文件
老師裁決
- 描述情境、定義尺規
- 裁決題庫與遊戲規則
- 驗收、退件與親自測試
我不必會寫程式,卻必須清楚知道學生要練什麼。
紅線:把教學專業,寫成 AI 的規則
工作流裡的守門點(Hook)與裁決關卡(Gate),最後寫進 Claude Code 每次開工必讀的專案守則 CLAUDE.md,化成七條「絕對紅線」:違反任何一條,AI 都必須停下來問我――這正是人在迴路(human-in-the-loop)的設計。
我最在意的,是尺規的數字,不讓 AI 自創。評量尺規(rubric)中的 123 架構(1 核心、2 面向、3 關鍵)、語速基準每分鐘 180 字,一律以核定的計畫書為準;標示「待補」的,就停下來問。因為生成式 AI 會一本正經地補上看似合理的數字,也就是所謂的AI 幻覺(hallucination)。
一個看似合理、卻未經核定的數字,就可能讓學生練偏了方向。
- 01版本與表態,完整留存每個講稿版本與學生的每一次表態,都要入庫。
- 02尺規數值,不得自創我最在意以核定的計畫書為準;標示「待補」就停下來問。
- 03學生個資,不送進 AI系統內以匿名代碼運作。
- 04範文由老師提供不由 AI 生成充數。
- 05提示詞要有版本每次修改都記錄原因。
- 06對抗測試必跑不能被「套公式」的講稿騙到高分。
- 07部署由老師親按AI 只準備,不代按。
AI 碰到紅線就停下來問――把「不確定」交回給人,正是紅線存在的意義。
回饋要具體:從無異議回饋到證據式檢核
系統還在開發,我先模擬學生的角色試玩,發現早期的回饋看起來工整,卻沒有指出問題、也沒有給方向。我直接退件:「這是無異議回饋,無法讓學生進步。」
於是回饋改成「證據式檢核」:開講前先亮出檢核單;講完逐條對照,通過的引用學生原句當證據,沒過的給具體提醒,過關後再給「更上一層」的建議。這呼應了 Hattie 與 Timperley 對有效回饋的提醒:往哪裡去、做得如何、下一步是什麼。
改講稿時,決定權則交還學生:對小雀的每一條建議,都要表態――採納、部分採納或拒絕,並寫下理由,才能存成新版本。這是一種後設認知(metacognition)的練習,也是我的期待:學生未來能運用 AI 完成任務,也能掌握品質,為自己的決定負責。
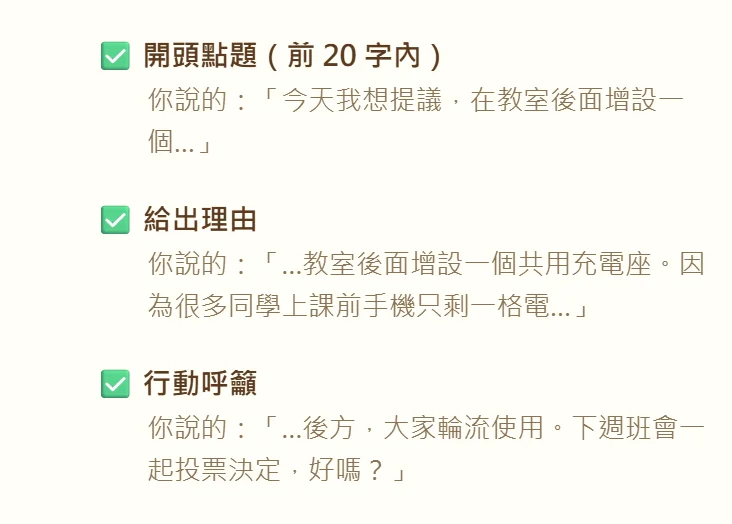
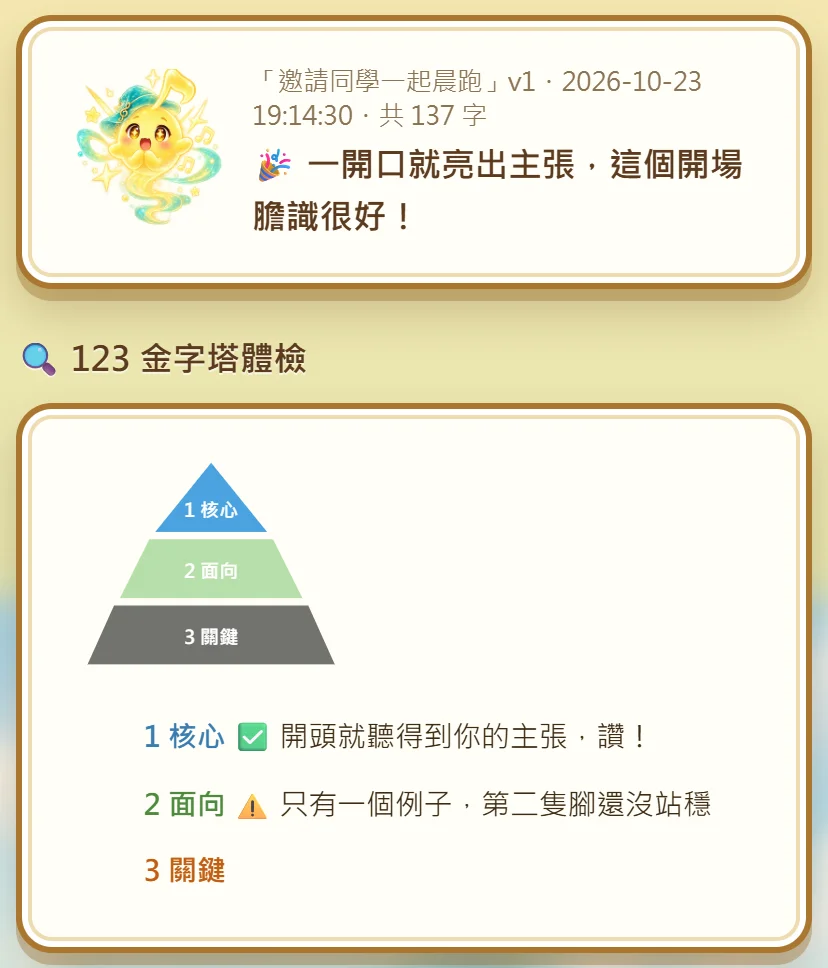
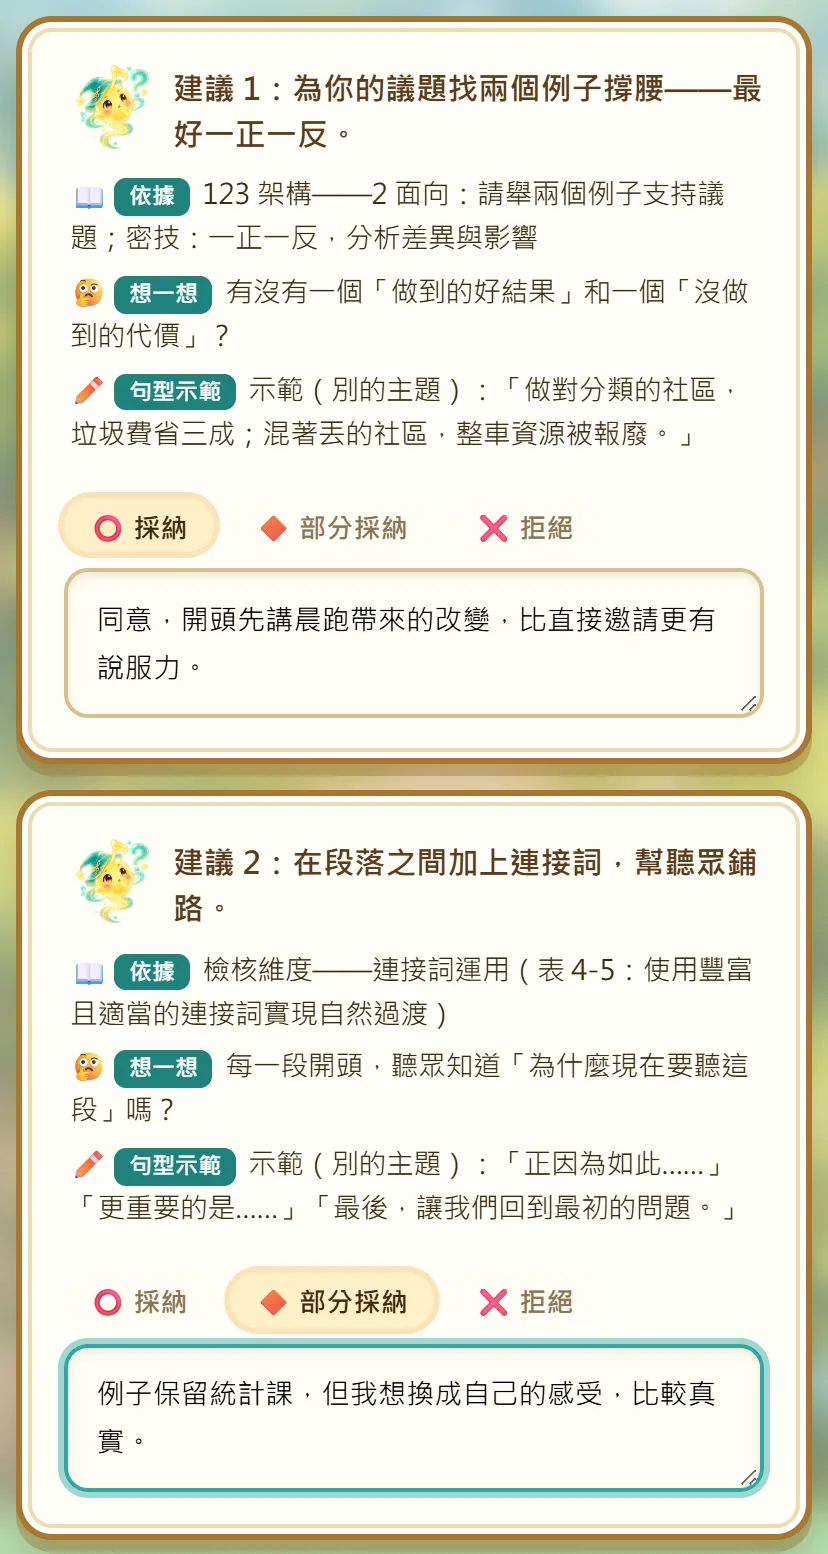
我對 AI 的產出做裁決;學生,也該學會對 AI 的建議做裁決。
每一版,都自己當學生測
Q1關掉錄音、改用打字,也能過關?
同樣在模擬學生時,我故意不開口、關掉錄音,直接打字――竟然也能過關。當天就補上三道門檻:錄音不足 8 秒、不滿 20 字、語速低於每分鐘 60 字(像在打字),一律判定無效;低於標準,也不給分。
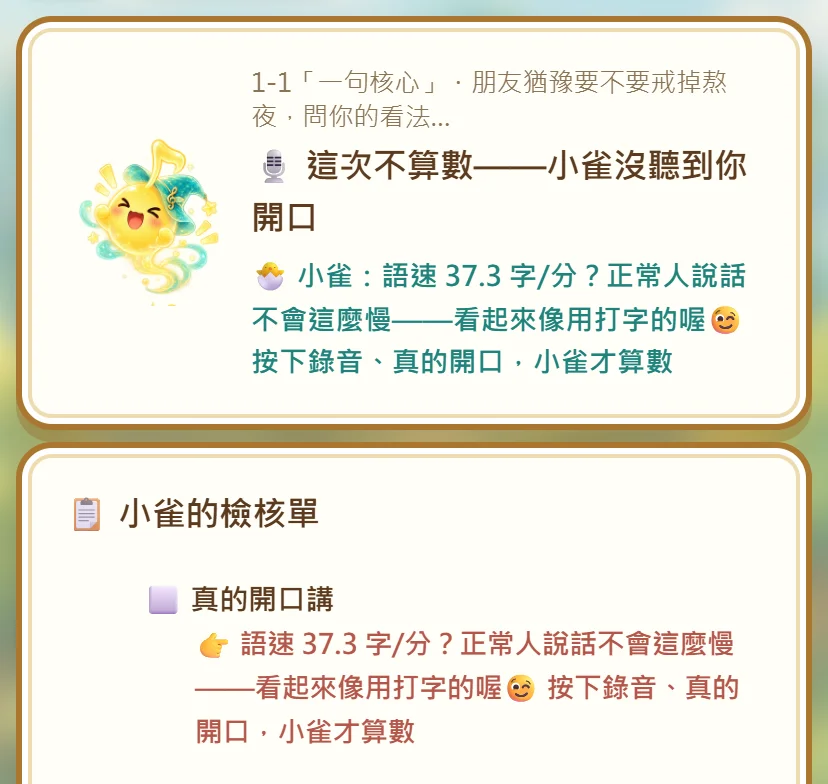
Q2第一層就這麼難,後面反而簡單?
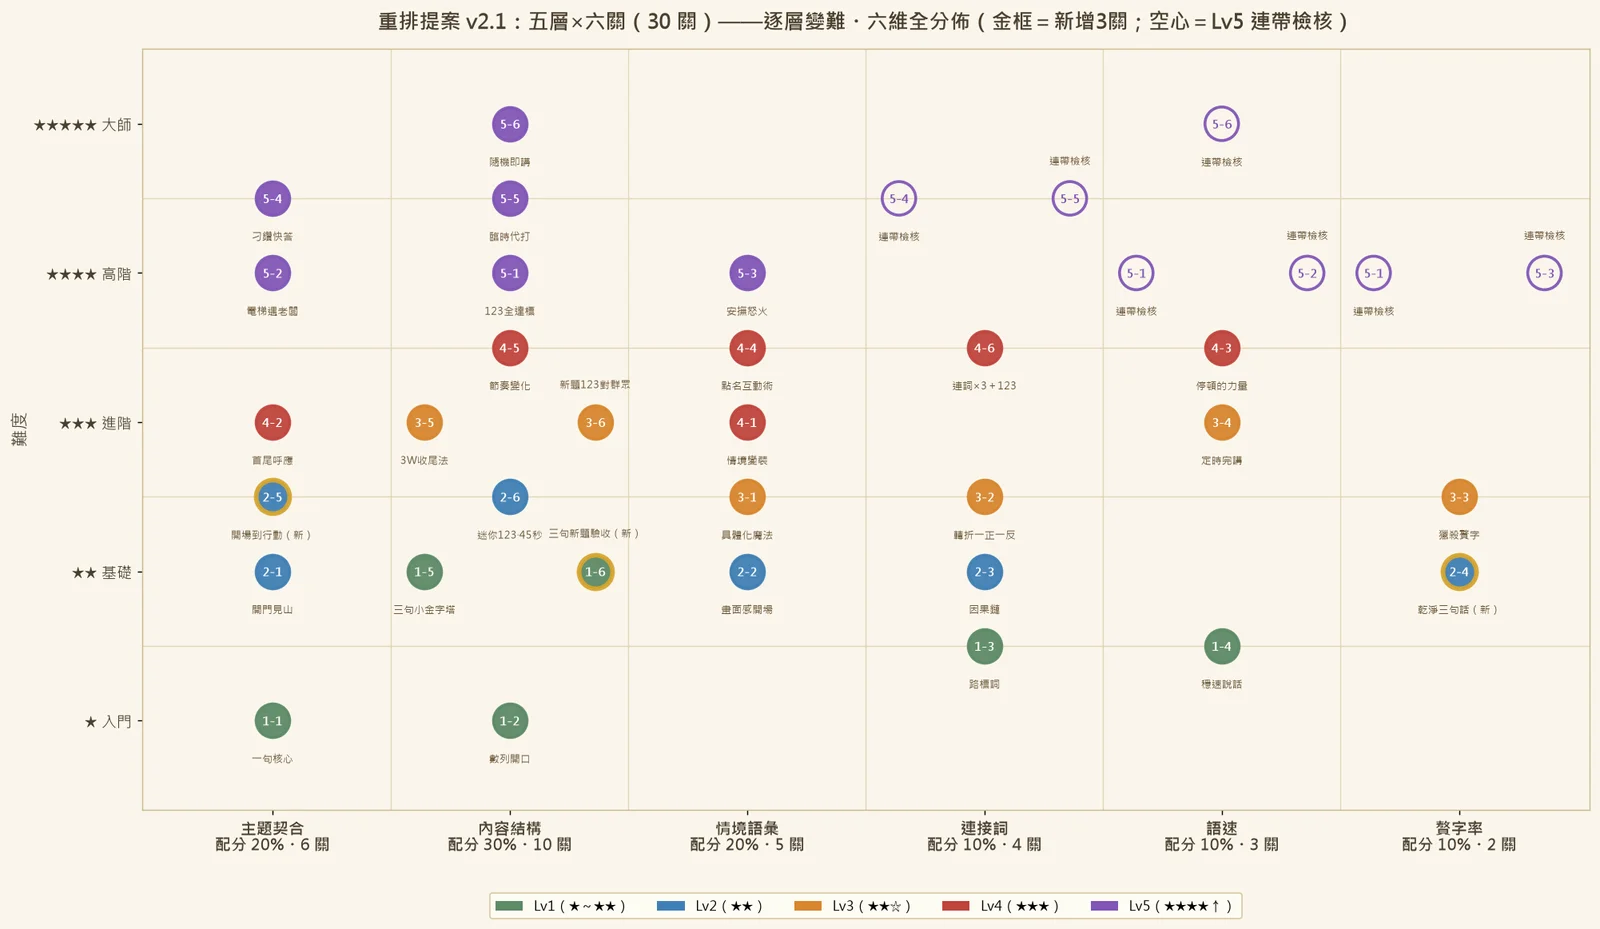
題庫累積到數十題時,我請 AI 畫一張圖,對照每一題的維度、關卡與難度。圖一畫出來就看見問題:第一層就衝得很難,後面的關卡反而簡單,六個維度的分佈也不均勻。
我決定先回到評量的基本盤――一段好的說話,應該包含哪些面向?――以尺規的六個維度為統一標準,重新對照每一題,再依螺旋式課程(spiral curriculum)的精神重排;重排後的分佈,就是文首那張圖。
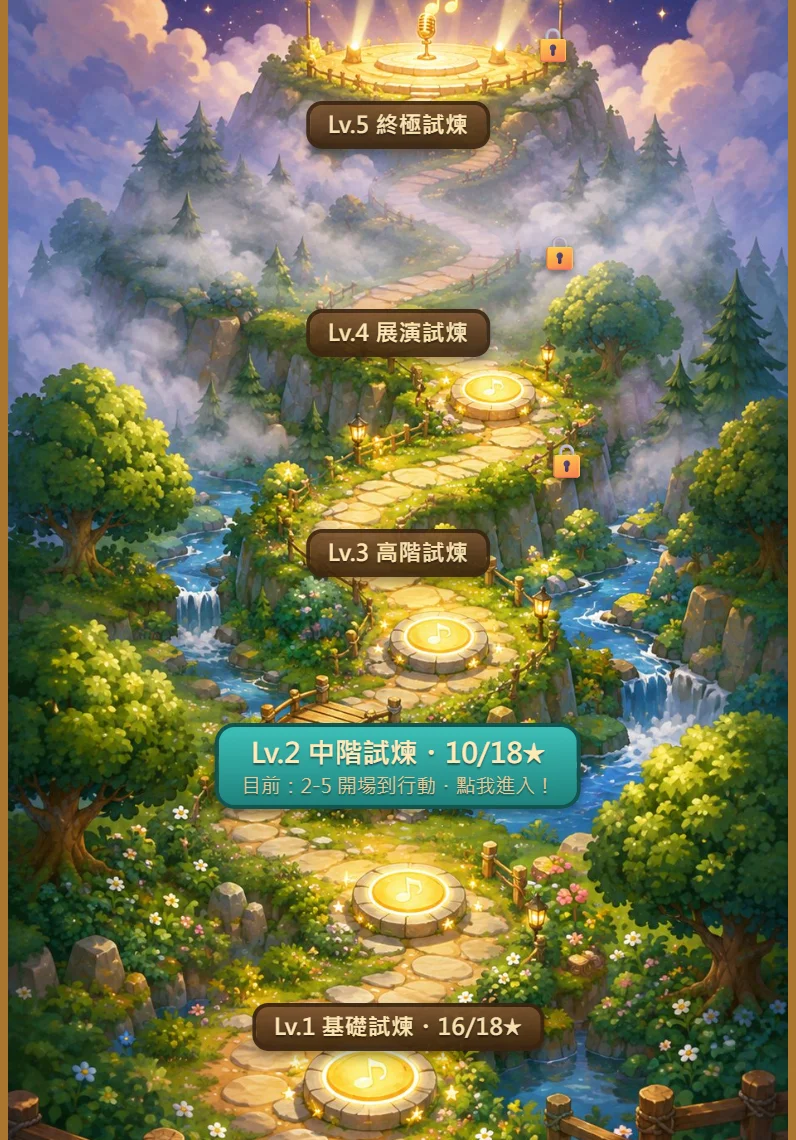
AI 不會主動指出哪裡不對;許多漏洞,要老師親自當一次學生,才測得出來。
誠實面對:辛苦與限制
- 01介面一直「很制式」最初的版面,我連續退件:「很制式」「沒有遊戲冒險感」「能不能是一個村莊?」命名改了好幾輪,攻略本的圖表也一度太可愛。後來我們約定:介面(UI/UX)改版,先討論、再動手。
- 02模擬回饋,有它的天花板AI 評分接上之前,系統只能檢核「說了什麼形式」:句型、字數、語速與贅字;內容是否言之有物,仍有待 AI 評分。
- 03真正的檢驗,在學生身上VoiceUp 預計今年 11 至 12 月測試,封測後,明年 2 月開學才正式使用。在此之前,所有設計都還沒有經過真實學生的檢驗。
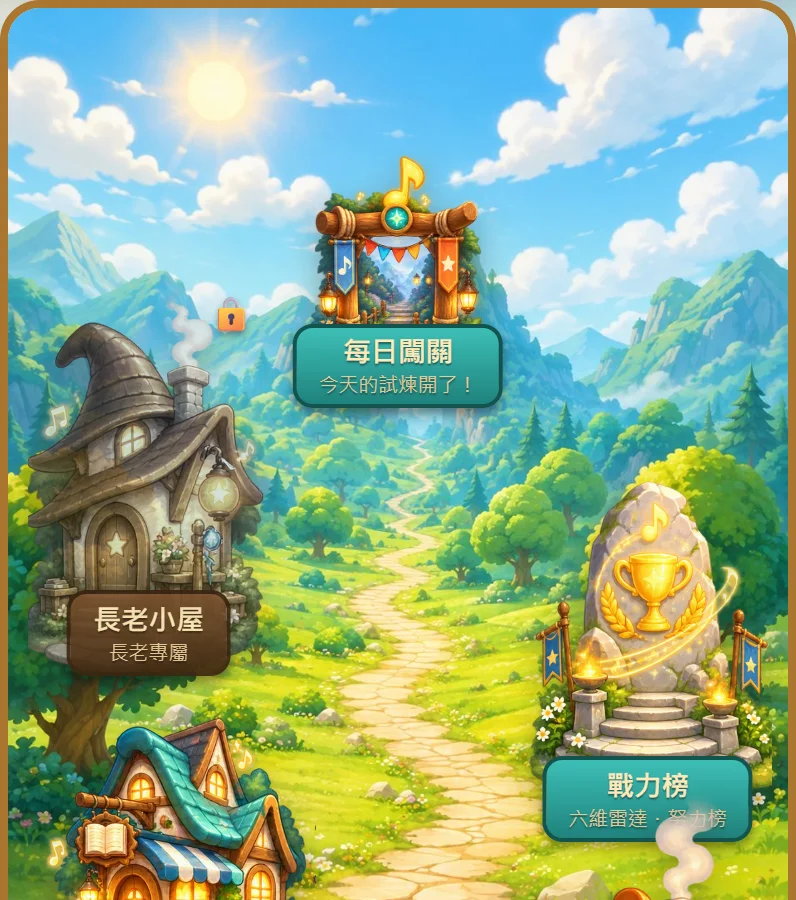
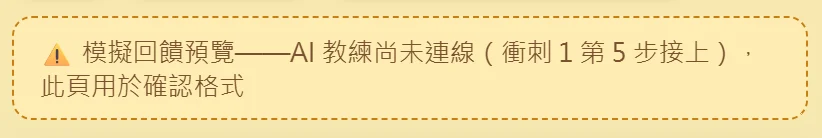
這些限制,有的靠技術持續改善,有的,則要交給真實的課堂來回答。
一位大學教師的省思:藍圖與驗收,留在老師手上
AI 可以施工;藍圖與驗收,必須由老師親自把關。
「非取代,而是適性陪跑」是 VoiceUp 的設計哲學,也是我與 AI 協作的方式。
- 01先把教學目標與尺規想清楚目標與尺規越清楚,AI 越不會偏離。
- 02每一版,都自己當學生測學生會遇到的漏洞,老師要先遇到。
進一步而言,當每一位老師都能與 AI 協作自建工具,我們也必須追問――
什麼是「好的表達」,由誰來定義?
AI 的回饋具體嗎?正確嗎?由誰來檢驗?
AI 的建議採不採納,由誰來負責?
所以三個答案都應該是「人」――老師定義與檢驗,學生決定與負責;惟有如此,AI 方能成為適性陪跑的夥伴。
未來,帶進教學與研發
教學:讓學生看見自己的取捨
封測後,VoiceUp 將於明年 2 月開學正式陪伴修課學生練習。每一個講稿版本、每一次採納或拒絕的理由都會留存;學生能回看自己的取捨,老師也能看見每一位學生的思考軌跡。
前篇研發手記 No.04〈遊戲化,不是花俏〉→研發:AI 評分,加上多元評量與校準
下一步是接上 AI 內容評分:系統門檻與規則檢核把關形式,AI 評內容,再加上教師評分、專家外評、學生互評與自評,多元評量、相互印證;並匯出評分樣本,與教師及專家評分對照校準,以教學實踐研究檢視學生口說表現的變化。
相關案例智匯共生〈自己先走一段,再陪更多人往前走〉↗🔒 VoiceUp 目前為研發測試版,尚未對外開放;文中截圖取自測試環境,暱稱、講稿與練習紀錄皆為虛構。
本文提及與延伸閱讀
- 工具Claude Code・Claude Cowork・ChatGPT(維基百科)
- 守則CLAUDE.md 專案記憶(Claude Code Docs)
- 概念Human-in-the-loop(維基百科)・人工智慧幻覺(維基百科)
- 回饋Hattie & Timperley (2007). The Power of Feedback
- 概念後設認知(維基百科)
- 概念螺旋式課程 Spiral approach(維基百科)
- 概念評量尺規 Rubric(維基百科)
- 計畫教育部教學實踐研究計畫
- 案例智匯共生〈自己先走一段,再陪更多人往前走〉
- 前篇研發手記 No.04:遊戲化,不是花俏
- 延伸研發手記 No.09:一個晚上,一間 KTV
- 下一篇研發手記 No.06:先有故事,才有畫面
交流園地
歡迎留下想法與我交流。填暱稱即可留言,留言會公開顯示,請勿留下個資。